Quel modèle d’IA pour quel usage ? Ce que nos tests en conditions réelles nous ont appris
Chaque mois apporte un nouveau modèle d’IA « en tête des classements ». Mais en tête de quoi ? Nous avons mis treize modèles face à sept situations de travail ordinaires : analyser un fichier complexe, corriger un document Word, lire une facture scannée, rédiger une relance… Les résultats bousculent quelques idées reçues, et permettent surtout de choisir avec méthode.
Pourquoi les classements officiels ne suffisent pas
Les éditeurs publient leurs modèles avec des scores à des épreuves standardisées. Elles portent des noms comme MMLU, GPQA ou SWE-bench. Ce sont des examens sérieux, mais ils répondent à une autre question que la vôtre :
- Ils mesurent des connaissances, souvent de niveau universitaire, et le plus souvent en anglais. Ils ne mesurent pas un savoir-faire dans votre métier.
- Ils testent le modèle seul, sans vos outils, vos documents ni votre plateforme. Or un modèle est rarement utilisé seul : il lit des fichiers convertis en texte, appelle des outils, suit des consignes posées par l’entreprise.
- Ils donnent un score unique, quand la vraie question est : ce modèle commet-il l’erreur qui me coûte cher ? Cette erreur peut être un chiffre faux, une consigne oubliée ou une information inventée.
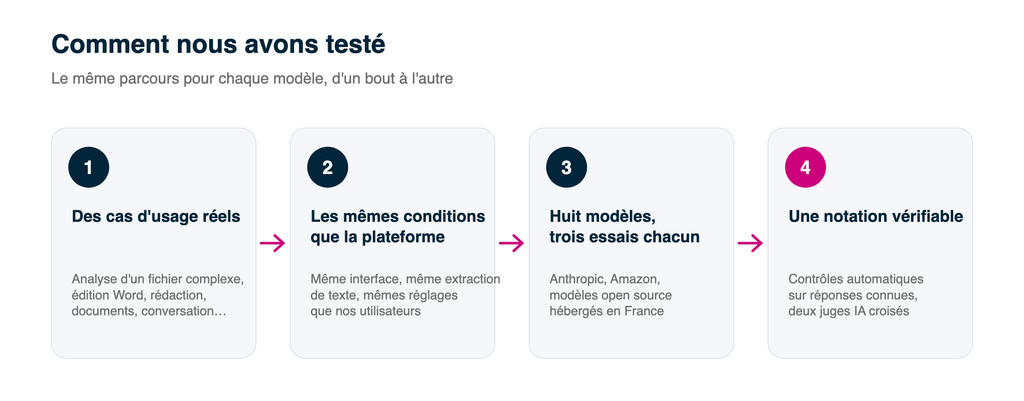
Nous avons donc construit nos propres épreuves, à partir des usages que nos clients nous décrivent, et nous les avons fait passer à treize modèles disponibles sur Agent Factory, notre plateforme d’IA agentique.
Une règle a guidé le choix des modèles : l’inférence doit avoir lieu en Europe. Nous n’avons retenu que des modèles servis depuis des centres de données européens : la région Europe d’AWS pour les modèles propriétaires, Scaleway en France pour les modèles open source. Certains modèles très attendus en sont exclus, comme les derniers GPT d’OpenAI : sur la plateforme que nous utilisons, ils ne sont proposés qu’avec un routage mondial, qui peut traiter les requêtes hors d’Europe. Pour une entreprise européenne, ce critère passe avant le classement.
Partie 1 – Le protocole : tester comme on travaille
Sept usages, pas des examens de culture générale
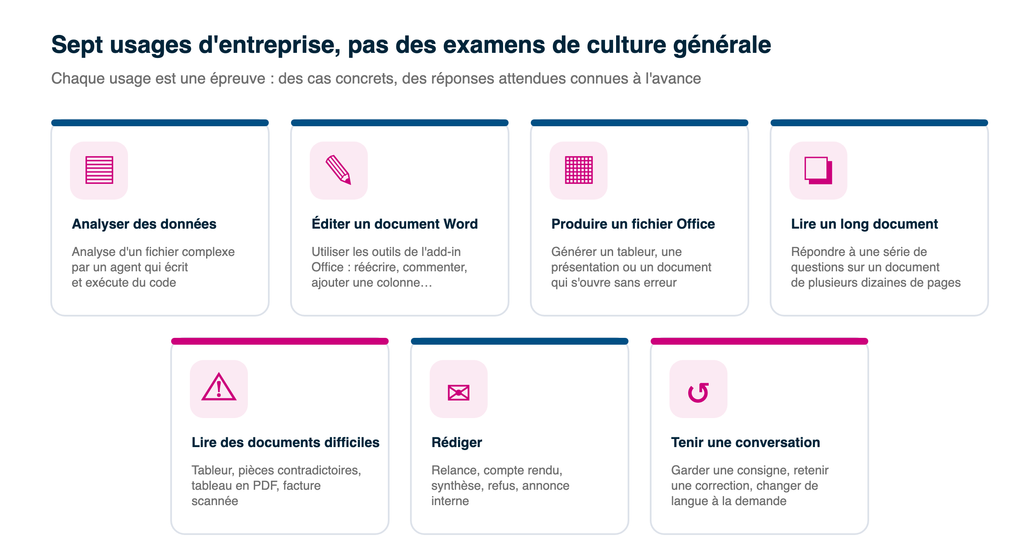
Chaque usage est une épreuve composée de cas concrets. Pour la plupart, la bonne réponse est connue à l’avance ; pour l’analyse de données et la rédaction, la qualité est appréciée par des juges (voir plus bas) :
| Usage | Ce que l’on demande au modèle |
|---|---|
| Analyser des données | Analyser un fichier de données réel, volumineux et anonymisé, pour en tirer un rapport. Le modèle écrit et exécute lui-même ses calculs |
| Éditer un document Word | Utiliser les outils de notre module Office pour réécrire un passage, commenter, insérer un tableau ou y ajouter une colonne |
| Produire un fichier Office | Générer un tableur, une présentation ou un document qui s’ouvre sans erreur |
| Lire un long document | Répondre à une série de questions sur un document de plusieurs dizaines de pages : extraire, calculer, repérer ce qui manque ou se contredit |
| Lire des documents difficiles | Un tableur à deux onglets, un contrat et son avenant face à une facture, un devis en PDF, une facture scannée |
| Rédiger | Une relance d’impayé, un compte rendu, une synthèse, un refus commercial, une reformulation, une annonce interne |
| Tenir une conversation | Garder une consigne sur plusieurs échanges, retenir un chiffre corrigé en route, changer de langue à la demande |
Les mêmes conditions que vos utilisateurs
Les modèles ont été testés à travers Agent Factory, avec ses réglages. Un document y est converti en texte exactement comme lorsqu’un collaborateur le joint à sa question. Une conversation reçoit les vraies réponses précédentes du modèle. Ce détail compte : nous verrons que plusieurs écarts viennent de la plateforme, et non du modèle.
Treize modèles, tous servis en Europe
| Famille | Modèles | Hébergement |
|---|---|---|
| Propriétaires | Claude Sonnet 4.6, Sonnet 5, Sonnet 5.5, Opus 5, Opus 5.5 et Haiku 4.5 (Anthropic) ; Nova Pro et Nova Micro (Amazon) | AWS Bedrock, région Europe |
| Open source | gpt-oss-120b (OpenAI), Mistral Medium 3.5 (Mistral AI), GLM 5.2 (Zhipu AI), Qwen 3.5 (Alibaba), DeepSeek V4 Flash (DeepSeek) | Scaleway, en France |
Claude Sonnet 4.6 sert de référence : c’est le modèle polyvalent le plus utilisé sur les plateformes Agent Factory de nos clients.
Une notation vérifiable
Deux méthodes, selon la nature de l’épreuve :
- Des contrôles automatiques, chaque fois que la bonne réponse est connue : un montant, une date, une colonne présente dans le document final, un fichier qui s’ouvre. C’est le cas de la grande majorité des épreuves.
- Deux juges IA croisés, quand il faut apprécier une qualité : la rigueur d’une analyse, le ton d’un courrier. Deux modèles différents notent chaque réponse selon une grille. Nous avons vérifié que leurs notes concordent et qu’aucun ne favorise ses propres réponses.
Chaque cas est joué trois fois par modèle, pour distinguer un comportement constant d’un accident. Enfin, chaque erreur relevée a été relue à la main. Plusieurs « échecs » venaient en réalité de notre correcteur, trop strict sur une formulation : ils ont été corrigés avant de publier les résultats.
Partie 2 – Ce que les résultats nous apprennent
1. Aucun modèle n’est le meilleur partout
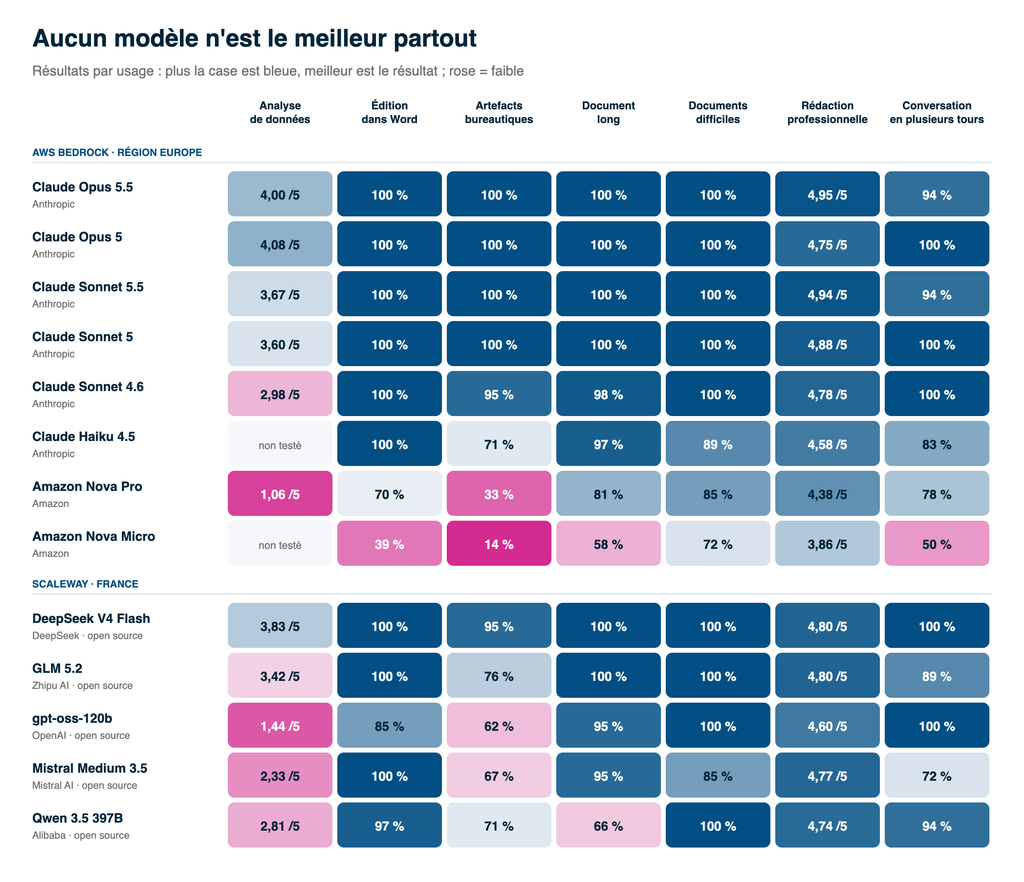
La carte se lit en colonnes : le classement change d’un usage à l’autre.
- Claude Opus 5 et Opus 5.5, les modèles haut de gamme d’Anthropic, sont les plus complets : 100 % sur presque toutes les épreuves à réponses connues, et les seuls au-dessus de 4 sur 5 en analyse de données. Ce sont aussi les plus chers.
- Claude Sonnet 5.5 fait jeu égal avec eux partout, sauf en analyse de données, pour moitié prix. Claude Sonnet 4.6, notre référence, reste très régulier.
- DeepSeek V4 Flash et gpt-oss-120b, deux modèles open source, font un sans-faute en conversation et sur les documents difficiles, pour une fraction du prix. DeepSeek n’excelle en analyse de données que si on le laisse réfléchir longuement. gpt-oss y décroche, comme en édition Word et pour produire des fichiers Office.
- Amazon Nova Micro, très bon marché, décroche dès que la tâche demande plus qu’une réponse courte. Amazon Nova Pro, son grand frère, reste dans le bas du classement sur tous les usages.
Choisir « le meilleur modèle » n’a donc pas de sens dans l’absolu : il faut choisir le meilleur modèle pour un usage donné.
2. Sur les tâches courantes, l’écart s’est refermé
En rédaction professionnelle, onze modèles sur treize obtiennent entre 4,6 et 5 sur 5 auprès de nos juges, pour des textes fidèles, bien construits et sans faute. Un courrier de relance ou une synthèse ne justifient plus le modèle le plus cher.
Le même constat vaut pour la lecture de documents simples : retrouver une date, un montant ou une clause est acquis par presque tous les modèles.
3. Ce qui sépare les modèles, c’est la vérification
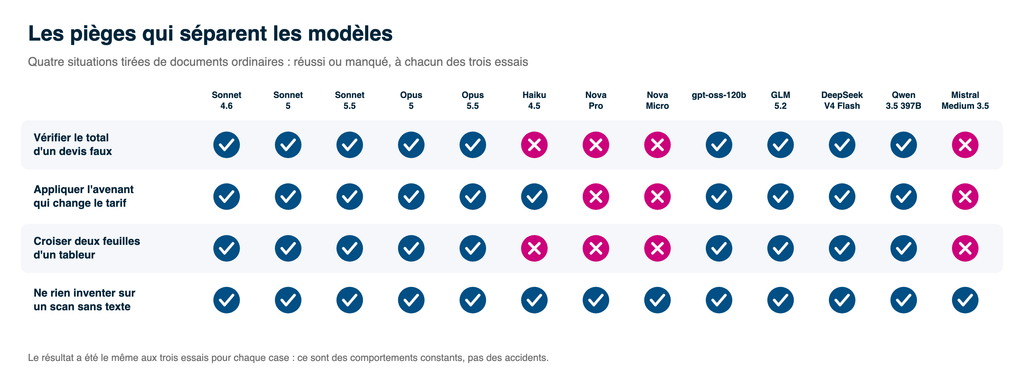
Les différences apparaissent dès qu’il faut vérifier plutôt que recopier :
- Un devis dont le total est faux. La somme des lignes ne correspond pas au total annoncé. Neuf modèles refont le calcul et signalent l’écart. Quatre recopient le total et le déclarent « cohérent », et ce à chaque essai.
- Un avenant qui change le tarif. La facture de mars applique encore l’ancien prix. Trois modèles ne voient pas l’avenant et valident la facture.
- Un tableur à deux onglets. Les objectifs sont sur le second. Quatre modèles se trompent sur les régions qui les ont atteints.
Ces erreurs sont constantes : le même modèle se trompe de la même façon aux trois essais. C’est une bonne nouvelle, car un défaut constant se détecte en test, avant la mise en production.
Autre résultat rassurant : face à un document illisible, aucun des treize modèles n’a inventé de contenu. Tous l’ont signalé.
4. Le coût d’une même tâche varie de 1 à 250
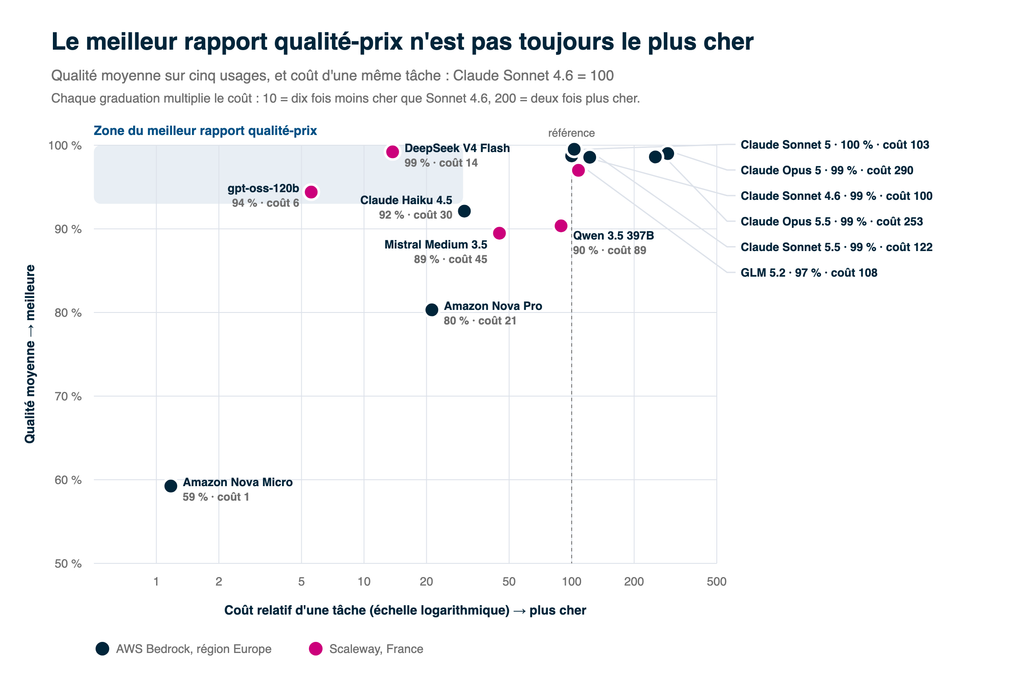
Pour une même tâche, l’écart de coût entre le modèle le moins cher et le plus cher dépasse un facteur 200. Surtout, coût et qualité ne vont pas de pair :
- DeepSeek V4 Flash atteint 99 % de qualité moyenne pour un coût plus de sept fois inférieur à celui de la référence. C’est le meilleur rapport qualité-prix de nos tests.
- gpt-oss-120b atteint 94 % pour un coût dix-huit fois inférieur.
- Claude Opus 5 et 5.5 coûtent deux fois et demie à trois fois la référence, pour un gain de qualité nul sur ces cinq usages courants. Leur avance ne paie qu’en analyse de données.
- GLM 5.2 et Qwen 3.5, open source, coûtent ici à peu près autant que les modèles Claude Sonnet.
- Claude Haiku 4.5 coûte trois fois moins cher que la référence, pour 92 %.
Une précision utile : comparez le coût d’une tâche terminée, pas le prix affiché par million de « jetons ». Un modèle bon marché qui réfléchit longuement ou s’y reprend à trois fois peut coûter plus cher qu’un modèle plus onéreux qui répond juste du premier coup.
5. « Réfléchir avant de répondre » : un levier puissant mais lent
Certains modèles peuvent raisonner avant de répondre. En analyse de données, ce mode fait passer DeepSeek du bas du classement au podium, de 1,8 à 3,8 sur 5, juste derrière les deux Opus, qui y arrivent sans raisonner.
Il a un prix : DeepSeek met jusqu’à quinze minutes pour un questionnaire que Claude Sonnet traite en une à deux minutes. C’est acceptable pour un traitement de fond, rédhibitoire pour un assistant conversationnel.
6. L’analyse chiffrée reste à relire
Même les meilleurs rapports d’analyse de données plafonnent à 2,5 sur 5 pour l’exactitude des chiffres. Les modèles repèrent bien les anomalies, structurent bien leur propos et rédigent bien. Mais aucun rapport n’était livrable sans relecture par un professionnel. L’IA accélère l’analyse ; elle ne la signe pas.
Conclusions : comment choisir vos modèles
Une grille de choix, en l’état de nos tests
| Usage | Premier choix | Alternative | À éviter |
|---|---|---|---|
| Rédaction courante | DeepSeek V4 Flash ou Mistral Medium 3.5 : qualité équivalente, coût négligeable | Claude Sonnet 5.5 pour les textes à fort enjeu | Nova Micro, Nova Pro |
| Assistant conversationnel | Claude Sonnet 4.6 ou 5 | DeepSeek V4 Flash ou gpt-oss-120b, aussi fiables, dix fois moins chers | Nova Micro, Nova Pro ; Haiku pour un usage bilingue |
| Factures, devis, contrats, tableurs | gpt-oss-120b ou DeepSeek V4 Flash, ou Claude Sonnet pour la rapidité | GLM 5.2, Qwen 3.5 | Haiku, Mistral et Nova Pro dès qu’un total doit être vérifié |
| Documents longs | Claude Sonnet 5 ou 5.5 | GLM 5.2, aussi fiable, deux fois moins cher | Nova Micro, Nova Pro |
| Analyse de données | Claude Opus 5 ou 5.5, les meilleurs, mais 6 à 7 € le rapport | DeepSeek V4 Flash en mode raisonnement, 15 fois moins cher, si dix minutes sont acceptables ; Claude Sonnet 5.5, GLM 5.2 | Mistral, Qwen, Nova Pro, gpt-oss-120b |
| Outils bureautiques (Word, fichiers Office) | Claude Sonnet 5.5 ou Sonnet 4.6 ; Opus au même niveau, plus cher — avec une limite de longueur des réponses bien réglée | DeepSeek V4 Flash, 100 % en Word et 95 % en fichiers Office, dix fois moins cher ; GLM 5.2, Mistral Medium 3.5 pour Word | Nova Micro, Nova Pro, gpt-oss-120b |
| Pièces scannées | Un modèle capable de lire les images : Claude, Qwen, Mistral, Nova Pro | Un module de reconnaissance de caractères (OCR) en amont | Le PDF scanné tel quel |
Six règles pour vos projets
- Pensez en portefeuille, pas en modèle unique. Un modèle économique pour les tâches courantes, un modèle haut de gamme pour celles qui engagent. Une plateforme qui donne accès à plusieurs modèles permet ce routage sans changer d’outil pour l’utilisateur.
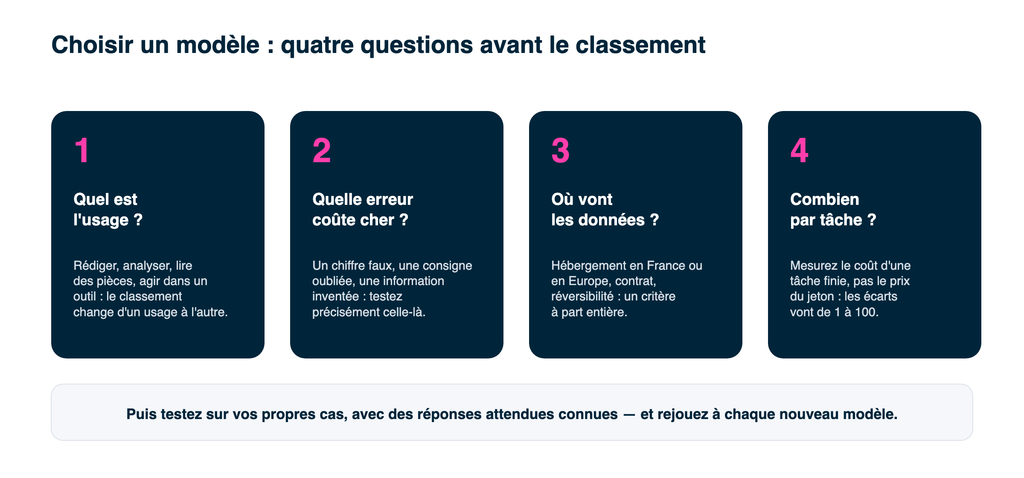
- Testez l’erreur qui vous coûte cher. Avant de déployer, identifiez la faute inacceptable pour l’usage visé, puis vérifiez que le modèle ne la commet pas. Ce peut être un montant faux, une clause manquée ou une consigne de forme oubliée.
- Testez sur vos propres documents, dans votre plateforme, avec vos réglages. Une partie des défauts n’est visible qu’en conditions réelles, et se corrige alors facilement.
- Comparez le coût par tâche, pas le prix du jeton.
- Faites de l’hébergement un critère de sélection. Des modèles open source hébergés en France atteignent désormais le niveau des meilleurs sur plusieurs usages. La souveraineté des données n’impose plus de renoncer à la qualité.
- Rejouez vos tests à chaque nouveau modèle. Les modèles évoluent tous les quelques mois. Des épreuves conservées et rejouables transforment chaque nouvelle annonce en une décision d’une journée, plutôt qu’en un pari.
Avec Agent Factory, Eurelis livre à chaque entreprise sa propre plateforme d’IA agentique : infrastructure dédiée hébergée en France, inférence en Europe, choix des modèles, connexion aux outils et aux données métier, contrôle des accès et des coûts. Vous voulez savoir quel modèle convient à vos cas d’usage ? Nous pouvons faire passer ces épreuves, ou des épreuves construites sur vos propres documents, aux modèles que vous envisagez.