RAG et données personnelles : masquer sans dégrader, avec Microsoft Presidio
Architecture, code et benchmark : comment nous protégeons les données personnelles avant chaque appel à un LLM, sans que l’utilisateur ne s’en aperçoive.
Construire un système RAG performant, c’est bien. Construire un système RAG conforme au RGPD sans dégrader l’expérience utilisateur, c’est un autre niveau de complexité. C’est pourtant ce qu’impose tout projet en production dès qu’il manipule des données réelles : contrats, tickets support, fiches clients, emails internes.
La question n’est plus « faut-il protéger les données personnelles ? » : c’est une obligation légale. La vraie question est : comment le faire sans casser le pipeline, sans ralentir le modèle, et sans que les utilisateurs ne s’en aperçoivent ?
Cet article présente l’approche que nous avons développée chez Eurelis dans notre fork open source de RAGFlow : une couche de masquage réversible des données personnelles, construite sur Microsoft Presidio et placée devant chaque appel au modèle de langage. Au programme : l’architecture, les briques de code qui font la différence, et un benchmark de modèles NER dont les résultats ont contredit notre intuition.
RAG et RGPD : un couple sous tension
Un pipeline RAG enchaîne plusieurs étapes de traitement. À chacune d’elles, des données personnelles peuvent transiter involontairement jusqu’à un modèle hébergé par un tiers.
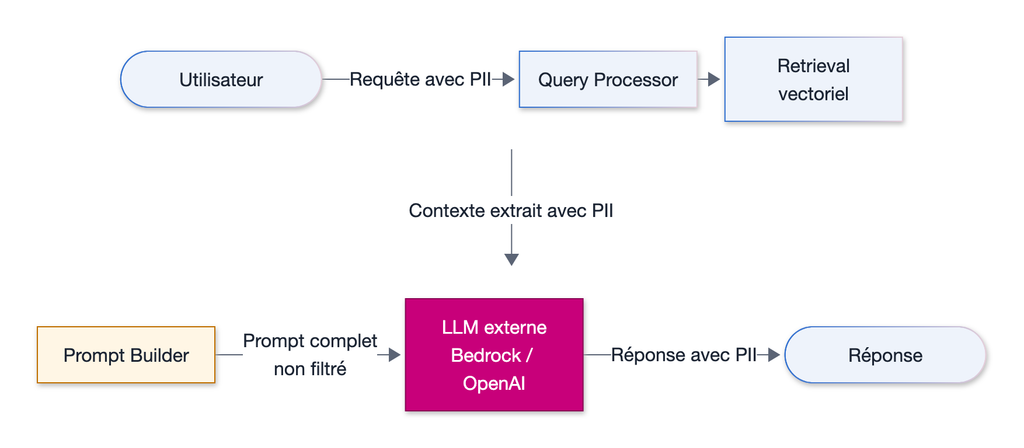
Sans protection, les données personnelles traversent tout le pipeline jusqu’au LLM externe.
Trois vecteurs de fuite coexistent :
- Les requêtes utilisateur : un collaborateur demande « quel est le numéro de téléphone de Marie Dupont ? », et le nom part tel quel vers le modèle externe.
- Le contexte extrait : le retrieval rapatrie des fragments de documents contenant noms, emails, coordonnées bancaires ou dates de naissance. C’est le vecteur le plus insidieux : ce n’est pas l’utilisateur qui a saisi la donnée, c’est le pipeline lui-même qui l’injecte.
- Les réponses du modèle : le LLM reformule, résume, parfois hallucine en s’appuyant sur les données personnelles présentes dans son contexte.
Le RGPD est explicite : l’article 5.1.c impose la minimisation des données, l’article 25 consacre la protection des données dès la conception (Privacy by Design) et l’article 32 exige des mesures techniques appropriées. Transmettre des données personnelles non pseudonymisées à un modèle hébergé par un tiers est, dans la plupart des cas, difficilement conciliable avec ces principes.
L’architecture cible : intercepter à la source
La réponse consiste à introduire une couche de masquage centralisée entre le pipeline RAG et le modèle de langage. Elle remplit quatre fonctions :
- Détecter les entités personnelles dans les messages sortants : requête utilisateur et contexte documentaire.
- Substituer les valeurs par des placeholders typés :
<PERSON_1>,<EMAIL_ADDRESS_1>. - Transmettre le texte pseudonymisé au LLM.
- Réhydrater la réponse : remplacer les placeholders par les valeurs originales avant de l’afficher.
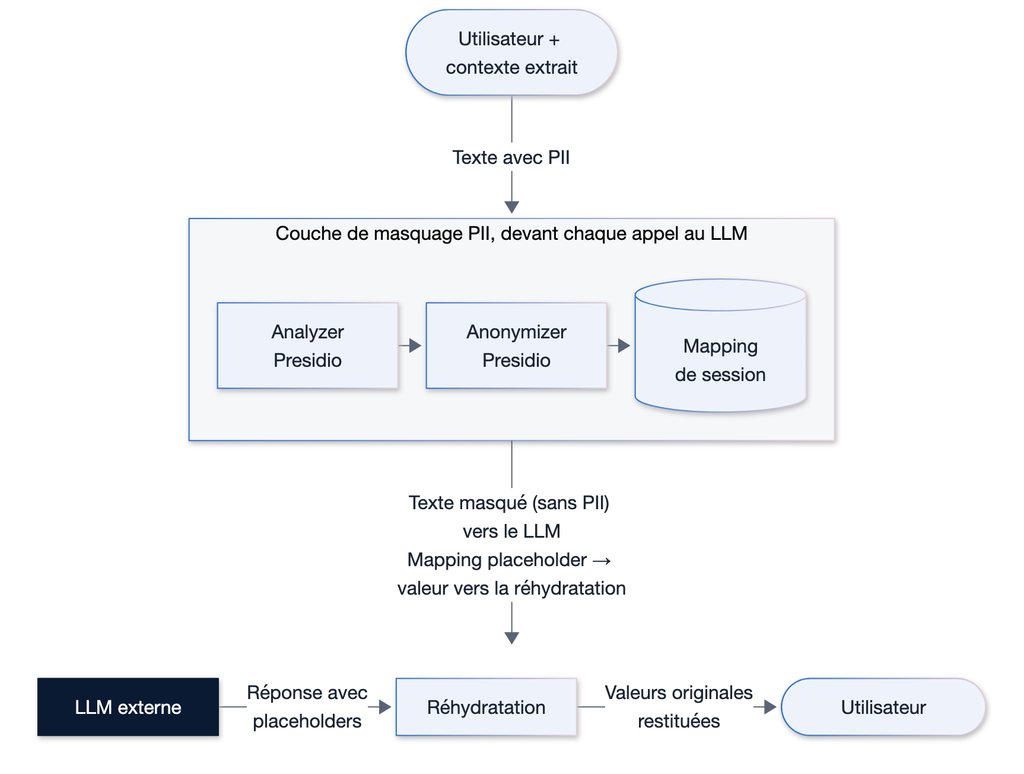
Le LLM ne voit que des placeholders ; la correspondance avec les valeurs réelles ne quitte jamais votre infrastructure.
Le LLM ne voit jamais les valeurs originales. Il travaille sur des jetons comme <PERSON_1>, qu’il manipule de façon remarquablement cohérente dans ses réponses. C’est ce qui distingue le masquage réversible d’un simple filtrage destructif : l’utilisateur obtient une réponse naturelle, avec les vrais noms ; le fournisseur du modèle, lui, n’obtient rien.
Dans notre fork de RAGFlow, cette couche s’insère à l’endroit unique où RAGFlow construit ses appels au LLM via LiteLLM. Le reste de RAGFlow ignore son existence, tout comme les applications clientes. C’est un principe que nous appliquons systématiquement : les règles de conformité ne doivent pas fuiter dans la logique métier.
Pourquoi Presidio ?
Nous avons évalué les principales solutions sur quatre critères : qualité de détection, latence, réhydratation native et intégration dans une stack basée sur LiteLLM.
| Critère | LLM Guard | Rehydra SDK | Filtre OpenAI | Microsoft Presidio |
|---|---|---|---|---|
| Réhydratation | ❌ Non native | ✅ Native | ❌ Non | ✅ Via opérateur custom |
| Déploiement | Open source, auto-hébergé | SaaS payant | SaaS, OpenAI uniquement | Open source (MIT), auto-hébergé |
| Entités supportées | 20+ | Configurable | Limité | 50+ types prédéfinis |
| Moteur NLP | Fixe | Propriétaire | Propriétaire | Configurable (spaCy, Stanza, Hugging Face) |
LLM Guard est séduisant, mais l’absence de réhydratation native est rédhibitoire dès qu’une conversation doit rester cohérente d’un tour à l’autre. Rehydra gère la réhydratation, mais son modèle SaaS crée une dépendance externe incompatible avec les exigences de souveraineté de plusieurs de nos clients. Presidio coche toutes les cases, et son architecture découplée est précisément ce qui le rend adapté à la production.
Deux moteurs, un rôle chacun
Presidio sépare le travail en deux composants indépendants :
AnalyzerEnginedétecte les entités et renvoie desRecognizerResult: type, position, score de confiance entre 0 et 1. Il ne modifie rien.AnonymizerEnginereçoit le texte et les résultats d’analyse, puis applique des opérateurs configurables par type d’entité.
Comme l’analyseur est en lecture seule, on peut journaliser quels types d’entités ont été détectés et avec quelle confiance, sans jamais écrire une valeur personnelle dans les logs. C’est exactement ce qu’attend un DPO.
L’analyseur combine trois techniques de détection :
- Les expressions régulières, pour les données structurées (emails, téléphones, IBAN, cartes bancaires), avec validation par checksum (Luhn, MOD-97) lorsque c’est possible, ce qui réduit fortement les faux positifs.
- La reconnaissance d’entités nommées (NER), pour les données non structurées (noms, lieux, dates), via un modèle spaCy.
- Des recognizers métier, pour vos propres identifiants : matricules, numéros de dossier, codes client. Des mots de contexte (« client », « compte »…) augmentent le score quand le motif apparaît dans un contexte cohérent.
from presidio_analyzer import AnalyzerEngine

analyzer = AnalyzerEngine()
texte = "Bonjour, je suis Alice Martin, mon email est alice@example.com et mon téléphone le +33 6 12 34 56 78."

for r in analyzer.analyze(text=texte, language="en",
                          entities=["EMAIL_ADDRESS", "PHONE_NUMBER", "PERSON"]):
    print(r.entity_type, round(r.score, 2), texte[r.start:r.end])
⚠️ Sans modèle NER, les entités
PERSONetLOCATIONne sont tout simplement pas détectées. Les regex ne couvrent que les données structurées. Le choix de ce modèle fait l’objet de la dernière partie de cet article.
Le cœur de la réhydratation : des placeholders numérotés et cohérents
L’opérateur replace natif de Presidio transforme tous les emails en <EMAIL>. Suffisant pour anonymiser, inutilisable pour réhydrater : si l’utilisateur cite deux adresses différentes, impossible de savoir laquelle correspond à quoi.
La solution est un petit mapper, branché comme opérateur custom, qui garantit qu’une même valeur reçoit toujours le même placeholder :
from collections import defaultdict
from presidio_anonymizer import AnonymizerEngine
from presidio_anonymizer.entities import OperatorConfig


class PlaceholderMapper:
    """Une même valeur PII reçoit toujours le même placeholder."""

    def __init__(self):
        self._counters = defaultdict(int)
        self._value_to_placeholder = {}
        self.placeholder_to_value = {}  # ← ce dont la réhydratation a besoin

    def get_or_create(self, entity_type: str, value: str) -> str:
        if value in self._value_to_placeholder:
            return self._value_to_placeholder[value]
        self._counters[entity_type] += 1
        placeholder = f"<{entity_type}_{self._counters[entity_type]}>"
        self._value_to_placeholder[value] = placeholder
        self.placeholder_to_value[placeholder] = value
        return placeholder


mapper = PlaceholderMapper()
anonymizer = AnonymizerEngine()

def operateur(entity_type: str) -> OperatorConfig:
    return OperatorConfig("custom", {"lambda": lambda v: mapper.get_or_create(entity_type, v)})

operateurs = {e: operateur(e) for e in ["PERSON", "EMAIL_ADDRESS", "PHONE_NUMBER", "DATE_TIME"]}
Deux détails font toute la différence dans une vraie conversation RAG.
Partager un seul mapper sur tous les messages. Le contexte envoyé au LLM est une liste de messages : prompt système enrichi des documents extraits, questions de l’utilisateur, réponses précédentes de l’assistant. En instanciant le mapper une fois par conversation, <PERSON_1> désigne la même personne dans le document, dans la question et dans la réponse précédente. Le LLM peut raisonner de façon cohérente sur cet individu sans jamais connaître son nom.
[SYSTEM]    Customer <PERSON_1> (<EMAIL_ADDRESS_1>) filed complaint #4521 on <DATE_TIME_1>.
[USER]      Can you summarize <PERSON_1>'s complaint?
[ASSISTANT] I can see <PERSON_1> filed a complaint.
Ne pas chercher de sens à la numérotation. Presidio applique ses opérateurs en partant de la fin du texte : dans « Alice a écrit à Bob », Bob peut tout à fait devenir <PERSON_1>. Seule compte la stabilité de la numérotation, pas son ordre.
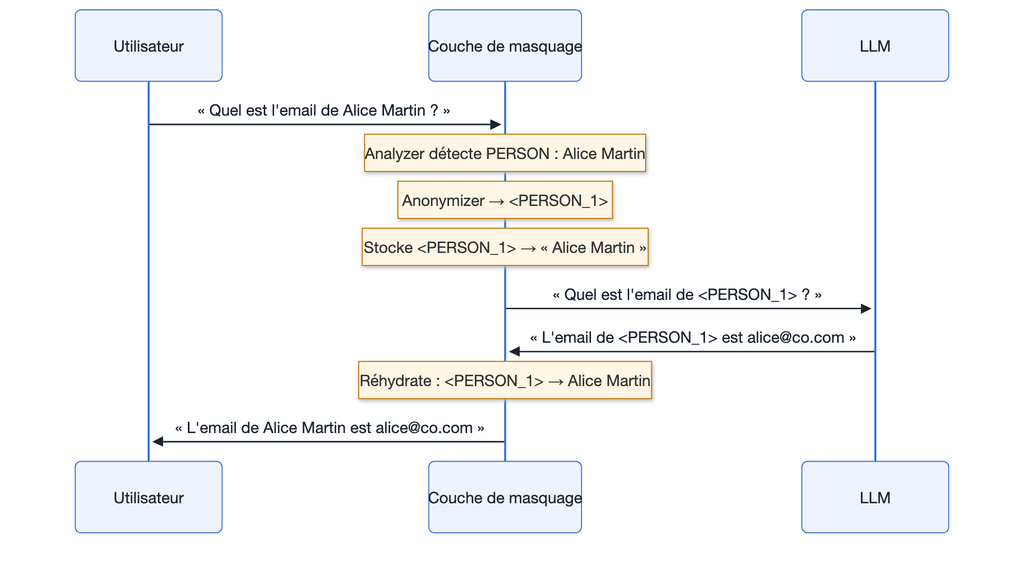
Le LLM ne manipule que des placeholders ; la valeur réelle est restituée au retour.
Réhydrater : trivial… sauf en streaming
Sans streaming, la réhydratation est un simple remplacement de chaînes, avec un piège : il faut remplacer les placeholders les plus longs en premier, sinon <PERSON_1> « mange » le début de <PERSON_10>.
def unmask_text(texte: str, mapping: dict[str, str]) -> str:
    for placeholder in sorted(mapping, key=len, reverse=True):
        texte = texte.replace(placeholder, mapping[placeholder])
    return texte
En streaming (SSE), le LLM émet sa réponse par morceaux, et un placeholder peut être coupé entre deux chunks : Bonjour <PERS puis ON_1>, votre. Une réhydratation naïve chunk par chunk afficherait des fragments bruts à l’utilisateur.
La parade : un petit buffer glissant, qui retient l’émission à partir de tout < non refermé en fin de buffer, et libère immédiatement tout ce qui précède.
class StreamingUnmasker:
    def __init__(self, mapping: dict[str, str], max_placeholder_len: int = 40):
        self.mapping = mapping
        self._max = max_placeholder_len
        self._buffer = ""

    def process_chunk(self, chunk: str) -> str:
        self._buffer += chunk
        safe_end = len(self._buffer)
        last_open = self._buffer.rfind("<")
        if last_open != -1:
            fin = self._buffer[last_open:]
            if ">" not in fin and len(fin) <= self._max:
                safe_end = last_open  # placeholder possiblement en cours
        sur, self._buffer = self._buffer[:safe_end], self._buffer[safe_end:]
        return unmask_text(sur, self.mapping)

    def flush(self) -> str:
        reste, self._buffer = self._buffer, ""
        return unmask_text(reste, self.mapping)
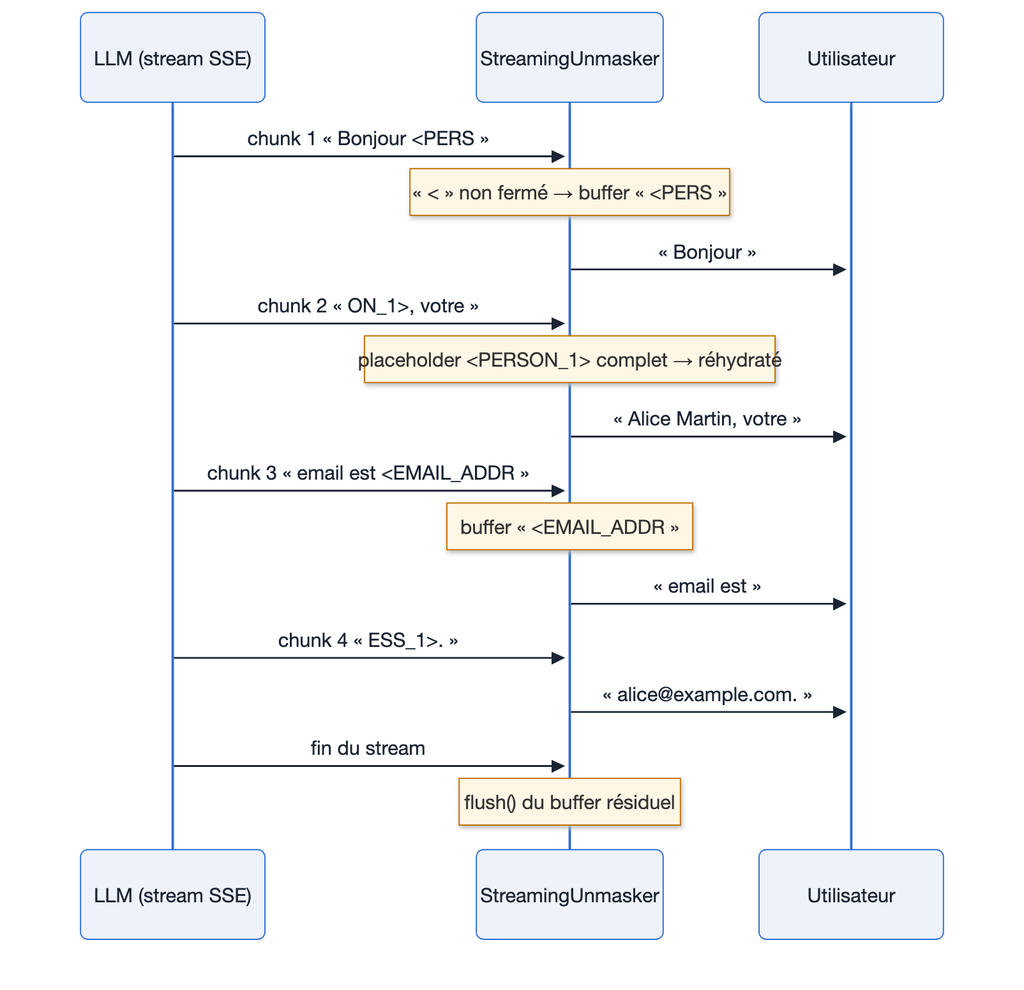
Seul le fragment potentiellement coupé est retenu ; tout le reste est émis sans latence supplémentaire.
La limite de longueur a son importance : un < isolé dans un texte ordinaire (une comparaison, un fragment HTML) ne doit pas bloquer le flux indéfiniment.
Masquer ou bloquer ?
Toutes les entités ne méritent pas le même traitement. Dans notre implémentation, chaque type d’entité reçoit une action et, si besoin, un seuil de confiance dédié, le tout configuré par variables d’environnement :
PII_MASKING_ENTITIES=PERSON:MASK,EMAIL_ADDRESS:MASK,CREDIT_CARD:BLOCK
PII_MASKING_SCORE_THRESHOLD=0.7
PII_MASKING_SCORE_OVERRIDES=PERSON:0.85,CREDIT_CARD:0.5
MASK pseudonymise et laisse passer la requête. BLOCK la refuse avant qu’elle n’atteigne le LLM : c’est le bon comportement pour un numéro de carte bancaire ou de sécurité sociale, pour lesquels même une conversation pseudonymisée n’a pas lieu d’être. Le seuil abaissé sur CREDIT_CARD est volontaire : quand il s’agit de bloquer, mieux vaut privilégier le rappel.
Quel modèle NER choisir ? Un benchmark qui nous a surpris
Puisque les noms et les lieux exigent un modèle NER, reste à choisir lequel charger. L’intuition dit : plus gros, c’est mieux. Nous avons mesuré.
Le protocole. 16 textes annotés à la main (10 en anglais, 6 en français), représentatifs de ce qu’un RAG d’entreprise rencontre réellement : comptes rendus de réunion, fiches RH, extraits de contrats. Au total, 61 entités attendues de types PERSON, LOCATION et DATE_TIME. La difficulté va de « My name is John Smith and I live in London » à de vrais pièges : « Paris called to confirm the Lyon meeting on Tuesday » (ville ou prénom ?), noms non occidentaux, dates relatives comme « T3 2023 ». Chaque modèle passe 3 tours de chauffe puis 20 répétitions chronométrées, sur CPU (Apple M-series, sans GPU). Le matching est souple : détecter « John » pour « John Smith » compte comme un succès.
Anglais : le petit modèle gagne sur tous les axes
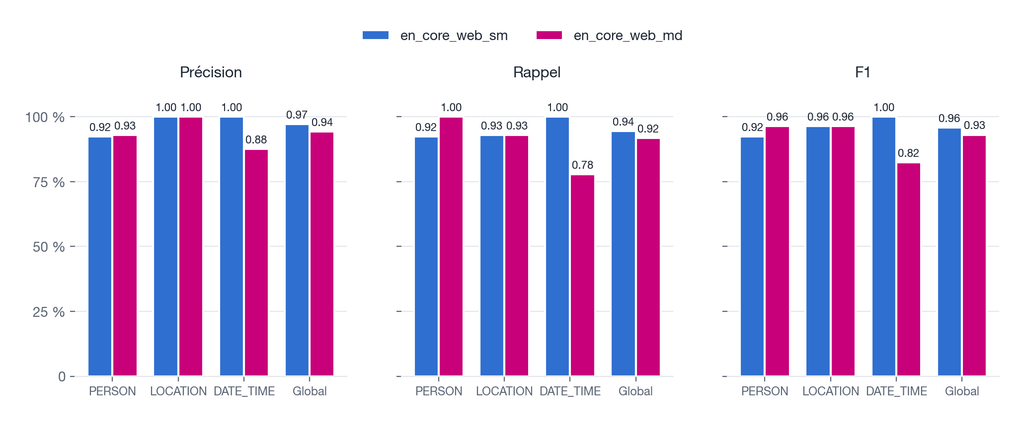
| Modèle | F1 | Précision | Rappel | Latence p50 | Débit | Taille |
|---|---|---|---|---|---|---|
en_core_web_sm | 0.96 | 0.97 | 0.94 | 3.3 ms | 300 textes/s | 15 MB |
en_core_web_md | 0.93 | 0.94 | 0.92 | 3.6 ms | 280 textes/s | 54 MB |
Le petit modèle est meilleur, plus rapide et 3,5 fois plus léger. L’écart se joue sur les dates : md manque ou étiquette mal plusieurs DATE_TIME que sm reconnaît (F1 de 0.82 contre 1.00), alors qu’il est légèrement meilleur sur les noms de personnes (0.96 contre 0.92). Les vecteurs de mots qu’apporte md servent les tâches sémantiques ; pour reconnaître des noms, des lieux et des dates dans ce type de textes, ils n’apportent ici aucun gain. Sur les cas difficiles, les deux modèles se dégradent de façon comparable (0.92 contre 0.87) : aucun ne tranche l’ambiguïté « Paris », qui relève d’un modèle transformer ou de règles métier.
En toute honnêteté, 16 textes indiquent une tendance, pas une loi. Mais c’est suffisant pour ne plus payer la taille par défaut.
Français : une bonne précision, mais aucune date
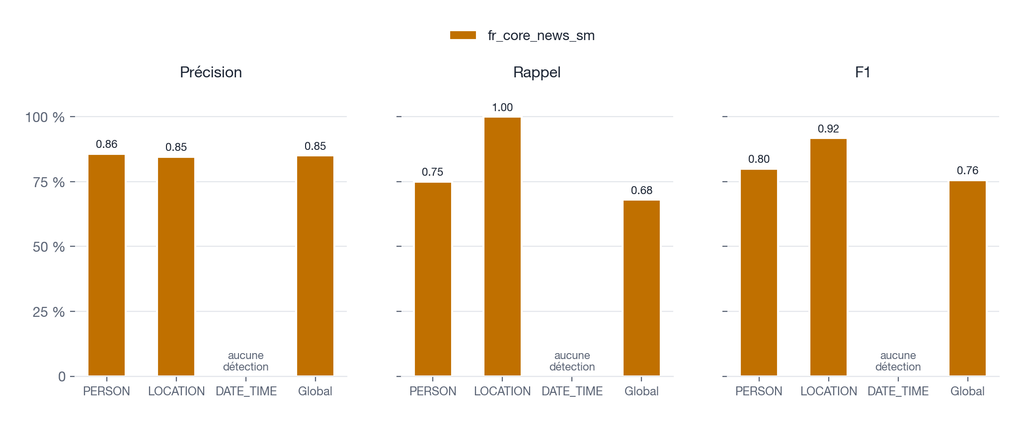
fr_core_news_sm atteint une précision de 0.85, mais un rappel de seulement 0.68. L’explication est simple : aucune date n’est détectée. Ce n’est pas une faiblesse du modèle, c’est un choix de conception : les modèles français de spaCy sont entraînés sur WikiNER, dont les étiquettes se limitent à PER, LOC, ORG et MISC. Aucun modèle spaCy français, quelle que soit sa taille, ne produira de date.
Conséquence pratique : en français, les dates relèvent de recognizers à base de regex (dates absolues, trimestres, jours de la semaine), pas du NER. Un modèle français plus gros améliorera le rappel sur les noms peu courants (0.75 sur PERSON, avec des manques sur des noms comme « Abderrahim Benali » ou « Hoa Nguyen »), mais ne réglera pas la question des dates.
Latence et mémoire : les modèles CNN tiennent la distance
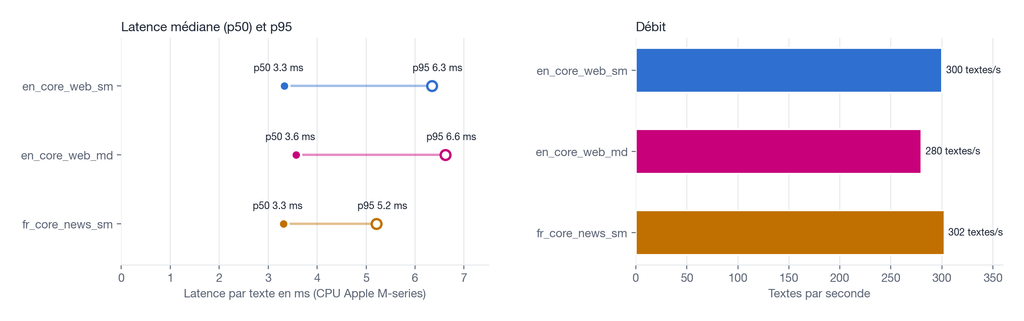
Les trois modèles se situent entre 3,3 et 3,6 ms en médiane, et entre 5 et 7 ms au 95e percentile par texte, sur un CPU de portable, avec une distribution très resserrée. C’est négligeable face à la latence d’un LLM, y compris en streaming avec de nombreuses requêtes simultanées. Un NER à base de transformer est au moins un ordre de grandeur plus lent sur CPU : acceptable en traitement par lots, plus difficile à justifier sur le chemin critique d’une requête.
L’empreinte mémoire reste modeste : 60 MB de pic au chargement pour en_core_web_sm, 183 MB pour fr_core_news_sm, 236 MB pour en_core_web_md. Un déploiement anglais + français en modèles sm tient dans environ 250 MB. À titre de comparaison, chaque modèle lg pèse à lui seul environ 560 MB sur disque.
Nos recommandations
| Contexte | Modèle anglais | Modèle français |
|---|---|---|
| Développement, CI, environnements contraints (valeur par défaut) | en_core_web_sm | fr_core_news_sm |
| Production où le rappel sur les noms rares est critique (8 GB+ de RAM) | en_core_web_lg | fr_core_news_lg |
| Qualité maximale en anglais, GPU disponible | en_core_web_trf | fr_core_news_lg |
Dans tous les cas, en français, ajoutez des recognizers regex pour les dates. Et gardez en tête que sans NER, seules les entités structurées (email, téléphone, carte bancaire, IBAN, adresse IP) sont couvertes : noms et lieux passent alors en clair.
Ce que cette architecture change en production
Trois bénéfices concrets ont justifié cette approche :
- Un point de contrôle unique. Toute la logique de protection vit dans une seule couche, devant l’appel au LLM. Rien ne change dans le pipeline RAG ni dans les applications clientes.
- La neutralité vis-à-vis des fournisseurs. Passer à Mistral, Gemini ou un modèle local ne touche pas à la couche de masquage : elle intervient avant le choix du modèle cible.
- L’auditabilité RGPD. Grâce à la séparation Analyzer / Anonymizer, on peut tracer les types d’entités détectées et leurs scores de confiance pour chaque requête, sans jamais écrire de valeur personnelle sur disque.
Le masquage n’est pas une solution miracle pour autant : la détection reste probabiliste, et une entité manquée passe en clair. Il faut le considérer comme une couche de défense parmi d’autres, à commencer par la gouvernance de ce qui est indexé, et toujours tester la détection sur vos documents et dans vos langues avant de faire confiance aux réglages par défaut.
Benchmark exécuté sur macOS (Apple M-series), CPU uniquement, Python 3.11, spaCy 3.8, Presidio Analyzer 2.x.