La donnée, socle de vos projets IA et de votre pilotage
De vos capteurs à vos tableaux de bord et à vos modèles IA, nous construisons une donnée structurée, accessible et fiable
Une IA performante ou un pilotage fiable reposent d’abord sur une donnée bien structurée, accessible et de qualité. Or vos données sont souvent dispersées entre des outils cloisonnés, des capteurs, des fichiers et des bases que personne ne relie.
Nous concevons vos infrastructures data, de la collecte à l’exploitation, pour donner à vos équipes et à vos projets IA une base solide. Ce travail est souvent invisible, mais c’est lui qui décide si un projet IA passe en production ou reste un prototype.
Vos enjeux
« Mes données sont partout, ma vue d’ensemble nulle part. »
ERP, CRM, outils métier, tableurs : chaque équipe a ses chiffres. Croiser deux sources demande des jours de manipulations manuelles.
« Nos capteurs produisent des volumes que nous n’exploitons pas. »
Les machines et les objets connectés remontent des mesures en continu. Elles sont stockées, rarement analysées, et les anomalies sont détectées trop tard.
« Notre projet IA bute sur la qualité des données. »
Données incomplètes, mal structurées ou contenant des informations personnelles : le modèle ne peut pas donner de bons résultats. Vous devez préparer la donnée avant d’espérer de l’IA.
« Nos modèles restent au stade du POC. »
Le prototype fonctionnait sur un extrait de données. En production, il faut des flux fiables, une supervision et un suivi de la performance dans le temps.
Ce que nous faisons
Portail data
Nous centralisons vos données dispersées dans un portail unique, avec des tableaux de bord et des vues adaptées à chaque profil : direction, métier, technique. Connecté à vos sources existantes (ERP, CRM, outils métier, bases de données), le portail devient le point d’entrée pour consulter, croiser et exploiter votre donnée.
Urbanisation du SI et données de référence
Votre système d’information s’est construit par couches : ERP, CRM, outils métier, logiciels SaaS, portails. Nous inventorions vos applications, vos flux et vos données de référence, puis nous organisons le SI en blocs aux responsabilités claires : qui détient quelle donnée, qui la modifie, qui la consomme. Vous obtenez une cible et une trajectoire par étapes, réalistes au regard de vos projets en cours, et des référentiels (clients, produits, contrats) dont une seule version fait foi.
Supervision industrielle et IoT
Nous collectons, structurons et valorisons les données de vos capteurs et objets connectés : supervision de production, maintenance prédictive, suivi en temps réel. Nos architectures absorbent le volume et la fréquence propres aux flux IoT, depuis la remontée des mesures jusqu’à leur exploitation dans vos outils de pilotage ou vos modèles IA. Pour les supervisions à grande échelle, nous migrons ces données vers le cloud.
Machine learning
Nous développons des modèles prédictifs et des algorithmes sur mesure, entraînés sur vos données : scoring, détection d’anomalies, prévision de la demande, classification automatique, analyse de corrélations entre de nombreuses variables. Chaque modèle est mis en production avec un suivi de sa performance dans le temps, pour rester fiable au-delà du POC.
Traitement des données pour l’IA
Avant qu’une IA générative ou un modèle de machine learning soit performant, la donnée doit être préparée : nettoyage, structuration, enrichissement, anonymisation. Nous mettons en place les pipelines qui transforment vos données brutes en données exploitables, avec la qualité et la traçabilité nécessaires. Pour les assistants qui interrogent vos documents (RAG), nous savons masquer les données personnelles sans dégrader les réponses.
Notre méthode
- Comprendre vos cas d’usage : ateliers avec vos équipes, cartographie des enjeux métier, priorisation des cas d’usage à fort impact.
- Analyser vos données : audit de leur disponibilité, de leur qualité et de leur structure ; analyse exploratoire ; préconisations sur les modèles et les indicateurs.
- Démontrer : un démonstrateur testé sur vos données réelles, avec un rapport de performance qui vous permet de décider.
- Industrialiser : intégration à vos systèmes, déploiement progressif, supervision et amélioration continue.
Pour votre DSI : des architectures cloud (AWS, GCP, Azure) ou hébergées chez vous, des pipelines documentés et supervisés, des bases adaptées au volume et à la latence (Google Cloud Bigtable, Elasticsearch, MongoDB), un écosystème Python ouvert (Pandas, Scikit-learn, TensorFlow, FastAPI). Vous gardez la maîtrise de vos données et de leur emplacement.
Pour vos directions métier : des indicateurs fiables et à jour, des alertes qui arrivent avant la panne ou le défaut, et des projets IA qui s’appuient enfin sur des données exploitables.
Des plateformes data en production chez Kestrel Vision, Mastrad et Euler Hermes
Une recherche publiée sur l’IoT industriel. Notre article AdaIV: Adaptive Information Value Ranking for AI-Driven Quality Control in Industrial IoT porte sur la hiérarchisation de l’information issue des capteurs pour le contrôle qualité par l’IA. Il s’inscrit dans notre programme de recherche agréé par le ministère de l’Enseignement supérieur et de la Recherche.
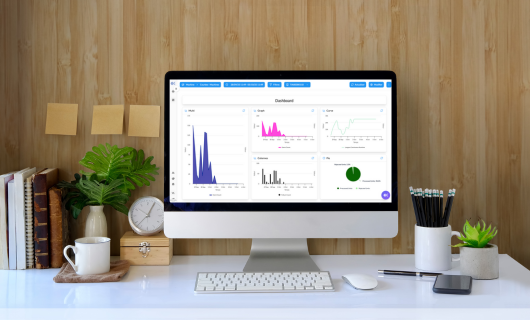
Kestrel Vision : plateforme data et IA
Une plateforme cloud unifiée de supervision industrielle, intégrant l’intelligence artificielle, dans une démarche de migration vers le cloud.

Mastrad : application intelligente
Intelligence artificielle et machine learning sur une architecture cloud serverless.

Euler Hermes : innover autour de la donnée
Concevoir une plateforme digitale pour exploiter la donnée autrement.
Questions fréquentes
Qu’est-ce que le data engineering ?
Le data engineering regroupe tout ce qui rend la donnée exploitable : collecte depuis les sources, transformation, stockage, mise à disposition et supervision des flux. C’est la fondation des tableaux de bord, des modèles de machine learning et des assistants IA. Sans elle, ces projets reposent sur des extractions manuelles et fragiles.
Pourquoi préparer ses données avant un projet IA ?
Un modèle d’IA reproduit les défauts des données qu’il reçoit : doublons, trous, erreurs ou informations sensibles. La préparation (nettoyage, structuration, enrichissement, anonymisation) conditionne la qualité des résultats et la conformité au RGPD. C’est aussi ce qui permet de passer du prototype à la production.
Pouvez-vous exploiter les données de nos machines et capteurs ?
Oui. Nos architectures collectent les mesures de vos capteurs et les stockent dans des bases adaptées au volume et à la fréquence des flux. Elles les rendent ensuite exploitables pour la supervision, les alertes et les modèles prédictifs. Notre travail de recherche sur l’IoT industriel, publié sous le nom AdaIV, porte précisément sur ces flux.
Nos données doivent-elles partir dans le cloud ?
Pas nécessairement. Nous concevons l’architecture selon vos exigences : cloud public (AWS, GCP, Azure), hébergement chez vous ou combinaison des deux. Le cloud facilite le passage à l’échelle pour les supervisions multi-sites, mais le choix vous revient.
Comment garantir qu’un modèle reste fiable dans le temps ?
Nous mettons en production chaque modèle avec un suivi de sa performance. Quand les données évoluent (nouvelle machine, nouveau produit, changement de process), les écarts sont détectés et le modèle est réentraîné. Ce suivi fait partie du projet, pas d’une option.
Qu’est-ce que l’urbanisation du système d’information ?
L’urbanisation consiste à organiser le SI comme une ville : en zones aux responsabilités claires, reliées par des voies de communication normalisées. Concrètement, on définit quelle application détient chaque donnée de référence et comment les autres y accèdent. L’objectif est de pouvoir faire évoluer une application sans déstabiliser les autres.
Faut-il tout refaire pour urbaniser son SI ?
Non. L’urbanisation fixe une cible, puis avance par étapes, au rythme de vos projets. Chaque nouvelle API ou chaque remplacement d’outil rapproche le SI de la cible. Les applications existantes sont conservées tant qu’elles rendent le service attendu.
Par où commencer ?
Par un cas d’usage précis et les données qui s’y rattachent. Nous analysons leur disponibilité et leur qualité, puis construisons un démonstrateur sur vos données réelles. Vous décidez d’industrialiser au vu des résultats mesurés.
Vos données peuvent faire plus pour vous
Parlez-nous de vos sources, de vos capteurs et de vos projets IA : nous vous proposons un premier cas d’usage à démontrer.