Mistral Large 4 à l’épreuve : ce que donne le nouveau modèle de Mistral AI face à nos tests de référence
La semaine dernières, nous publiions les résultats de treize modèles d’IA sur sept situations de travail réelles. Mistral AI propose depuis peu Mistral Large 4, son nouveau modèle phare. Nous lui avons fait passer exactement les mêmes épreuves. Verdict : un net progrès sur la génération précédente, un coût dix fois inférieur à notre référence, et un point faible à connaître avant de le déployer.
Les mêmes épreuves, les mêmes juges
Rien n’a changé depuis notre comparatif de référence : mêmes cas concrets, même plateforme, Agent Factory, mêmes contrôles automatiques et mêmes juges[^reference]. Chaque cas est joué trois fois, et chaque échec a été relu à la main avant d’être retenu.
Mistral Large 4 n’est proposé ni par AWS ni par Scaleway, les deux hébergeurs de notre comparatif. Nous l’avons donc appelé directement chez Mistral AI, en passant par son point d’accès européen : les requêtes y sont traitées dans des centres de données de l’Union européenne[^mistral-regional]. Notre règle reste la même : l’inférence doit avoir lieu en Europe. Le point d’accès par défaut de Mistral, lui, ne s’engage sur aucun lieu de traitement.
Le résultat en un coup d’œil
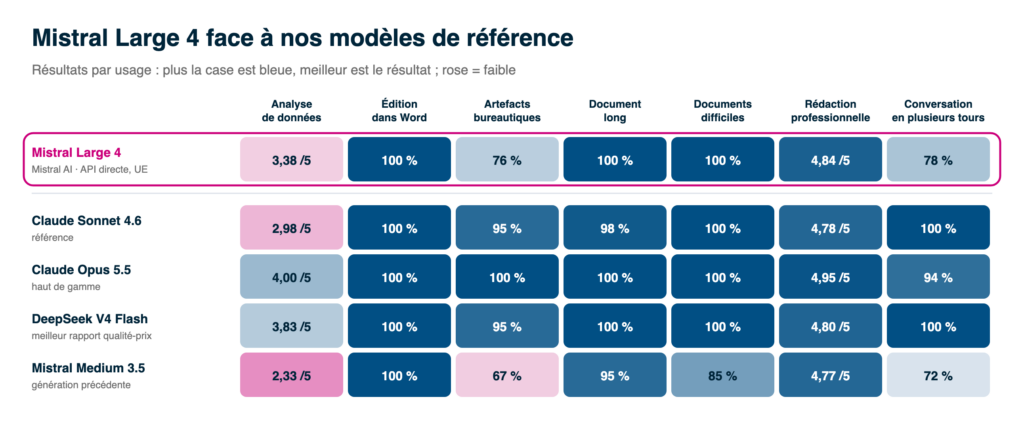
L’analyse de données et la rédaction sont notées sur 5 par deux juges. Les autres usages indiquent la part des contrôles réussis.
Nous le comparons à quatre repères de notre comparatif : Claude Sonnet 4.6, notre référence ; Claude Opus 5.5, le haut de gamme ; DeepSeek V4 Flash, le meilleur rapport qualité-prix ; et Mistral Medium 3.5, la génération précédente de Mistral, hébergée chez Scaleway.
| Usage | Mistral Large 4 | Mistral Medium 3.5 | Claude Sonnet 4.6 (référence) |
|---|---|---|---|
| Édition dans Word | 100 % | 100 % | 100 % |
| Lecture d’un long document | 100 % | 95 % | 98 % |
| Documents difficiles | 100 % | 85 % | 100 % |
| Rédaction professionnelle | 4,84 / 5 | 4,77 / 5 | 4,78 / 5 |
| Production de fichiers Office | 76 % | 67 % | 95 % |
| Conversation en plusieurs tours | 78 % | 72 % | 100 % |
| Analyse de données, sans raisonnement | 3,38 / 5 | 2,00 / 5 | 3,10 / 5 |
1. Un saut net par rapport à Mistral Medium
Sur les sept usages, Mistral Large 4 fait au moins aussi bien que Mistral Medium 3.5 partout, et nettement mieux sur trois d’entre eux :
- Les documents difficiles passent de 85 % à 100 %. Il refait le calcul d’un devis dont le total est faux, applique l’avenant qui change un tarif, croise les deux feuilles d’un tableur et refuse d’inventer le contenu d’un scan illisible. Ce sont précisément les pièges où Mistral Medium se trompait.
- L’analyse de données passe de 2,00 à 3,38 sur 5, à réglage égal.
- La production de fichiers Office passe de 67 % à 76 %.
En rédaction, il obtient 4,84 sur 5 auprès de nos juges : seuls trois modèles Claude font mieux, et aucun modèle d’un autre éditeur ne l’égale.
2. Sur les documents, il rejoint les meilleurs
Lecture d’un long document, documents difficiles, édition dans Word : 100 % sur les trois, sans un seul échec. Dans notre comparatif, seuls les Claude 5 et 5.5, GLM 5.2 et DeepSeek V4 Flash en faisaient autant.
C’est le cœur de nombreux usages en entreprise : retrouver une clause, vérifier une facture, corriger un document. Sur ce terrain, Mistral Large 4 peut remplacer un modèle beaucoup plus cher.
3. En analyse de données, il dépasse notre référence à réglage égal
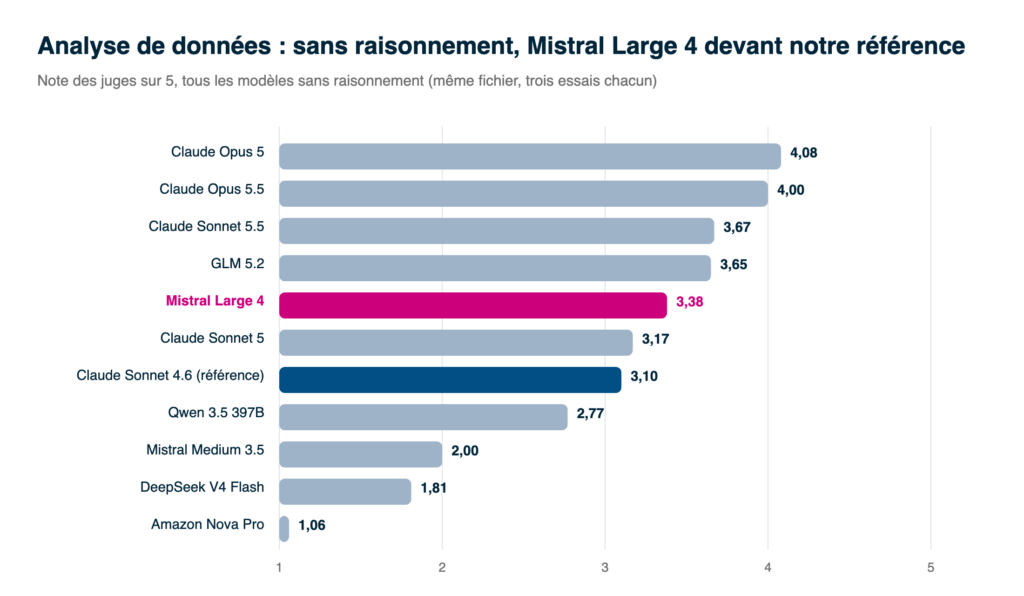
Un écart de moins de 0,2 point n’est pas une différence.
Comme les autres modèles qui le permettent, Mistral Large 4 peut raisonner avant de répondre. Nous l’avons testé sans ce mode, comme les modèles Opus. À ce réglage, il obtient 3,38 sur 5, devant Claude Sonnet 4.6 (3,10) mais derrière GLM 5.2, Claude Sonnet 5.5 et les deux Opus.
Trois nuances :
- Le résultat varie d’un essai à l’autre : 3,9, 2,3 puis 3,9. L’un des trois rapports était nettement plus faible.
- Il est lent : treize minutes par rapport en moyenne, contre six pour Claude Sonnet 4.6.
- Ses chiffres restent à vérifier : 2,2 sur 5 pour l’exactitude des montants. Comme pour tous les modèles testés, aucun rapport n’était livrable sans relecture par un professionnel.
En contrepartie, un rapport lui coûte 0,50 €, contre 3,67 € pour Claude Sonnet 4.6 au même réglage et 6,50 € pour Claude Opus 5.5.
4. Son point faible : la conversation
C’est le seul usage où Mistral Large 4 reste nettement sous notre référence, avec 78 % contre 100 %. Deux défauts reviennent :
- Il ne tient pas une consigne de langue. Quand on lui demande de répondre « en anglais uniquement », puis qu’on lui écrit en français, il repasse au français. Il l’a fait aux trois essais.
- Il interprète parfois mal un chiffre. Dans un budget de dépenses, il a une fois compté les salaires comme une recette, et calculé un solde au lieu d’un total.
Nous avons tenté de corriger ce défaut par une consigne permanente, ajoutée aux instructions du modèle : répondre dans la langue demandée pendant toute la conversation, même si l’utilisateur en change. Sans effet : il repasse toujours au français. Ce défaut tient au modèle lui-même.
Pour un assistant conversationnel, notamment bilingue, d’autres modèles restent plus sûrs : Claude Sonnet, DeepSeek V4 Flash ou gpt-oss-120b font 100 % sur cette épreuve.
5. Fichiers Office : une ligne de configuration corrige l’essentiel
Pour produire un fichier Word, Excel ou PowerPoint, nos modèles disposent d’une méthode écrite, que la plateforme leur propose de consulter au besoin. Quand l’utilisateur la cite dans sa demande, Mistral Large 4 réussit 100 % des essais. Laissé seul juge, il ne la consulte pas toujours : pour convertir un document Word, il s’en dispense et le fichier produit ne s’ouvre pas. Résultat : 76 %.
Nous avons ajouté une seule phrase aux instructions permanentes du modèle, en substance : « Avant de produire, convertir ou modifier un fichier Word, Excel ou PowerPoint, consulte toujours la méthode correspondante et suis-la, même si la tâche te semble simple. »
| Sans la consigne | Avec la consigne | |
|---|---|---|
| Méthode consultée | 83 % des essais | 100 % |
| Fichiers réussis | 76 % | 86 % |
La méthode est désormais consultée à chaque fois. Les échecs restants tiennent à l’exécution : deux conversions Word dont le fichier téléchargé s’écarte de l’aperçu affiché, et un plan comptable trop long, coupé avant la fin.
La leçon dépasse ce modèle : un réglage de quelques mots, posé une fois sur la plateforme, peut faire gagner dix points. C’est l’intérêt de tester un modèle dans sa plateforme, et non seul.
6. Dix fois moins cher que notre référence
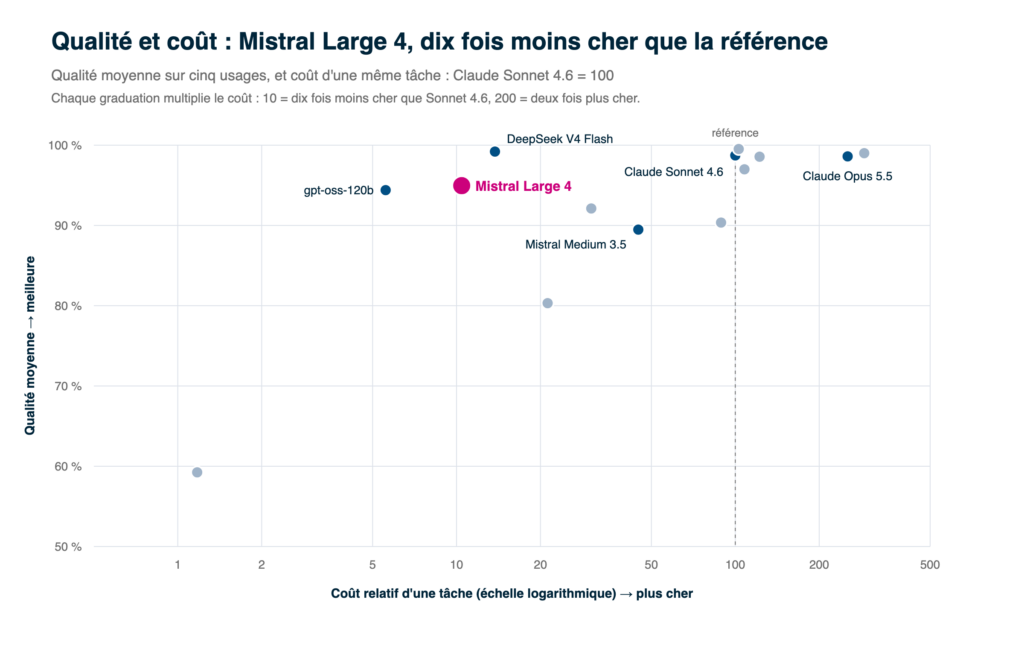
Coût de Mistral Large 4 au tarif promotionnel de Mistral AI ; au tarif normal, il doublerait.
Sur les cinq usages courants de notre comparatif, Mistral Large 4 atteint 95 % de qualité moyenne, pour un coût dix fois inférieur à celui de Claude Sonnet 4.6. Il est aussi quatre fois moins cher que Mistral Medium 3.5, pour une qualité supérieure de cinq points.
Il rejoint ainsi le groupe des modèles à très bon rapport qualité-prix, aux côtés de gpt-oss-120b (94 %). DeepSeek V4 Flash reste devant (99 %, pour un coût du même ordre), grâce à son sans-faute en conversation.
Une précision importante : ces coûts sont calculés au tarif promotionnel actuel de Mistral AI, réduit de moitié, et majoré de 10 % pour le traitement garanti en Europe[^mistral-prix]. Au tarif normal, Mistral Large 4 resterait environ cinq fois moins cher que notre référence.
Où le placer dans votre portefeuille
| Usage | Mistral Large 4 ? |
|---|---|
| Lecture de documents longs ou difficiles | Oui : 100 %, au niveau des meilleurs, dix fois moins cher |
| Édition dans Word | Oui : 100 % |
| Rédaction courante | Oui : meilleur résultat hors modèles Claude |
| Analyse de données | Possible, pour un traitement de fond qui supporte un quart d’heure d’attente et une relecture |
| Production de fichiers Office | Oui, avec une consigne qui lui fait consulter la méthode : 86 % |
| Assistant conversationnel, surtout bilingue | Non pour l’instant : préférer Claude Sonnet, DeepSeek V4 Flash ou gpt-oss-120b |
Mistral Large 4 élargit le choix des modèles européens de bout en bout : un éditeur français, un traitement dans l’Union européenne, et un niveau qui rejoint les meilleurs sur la lecture de documents. Pour une entreprise qui veut réduire sa dépendance aux fournisseurs américains, c’est une option sérieuse, à condition de garder un autre modèle pour la conversation.
Comme toujours, ces résultats valent pour nos épreuves et nos réglages, en octobre 2026. C’est la raison pour laquelle nos tests sont rejouables : un nouveau modèle se mesure en une journée, sur les mêmes bases.
Avec Agent Factory, Eurelis livre à chaque entreprise sa propre plateforme d’IA agentique : infrastructure dédiée hébergée en France, inférence en Europe, choix des modèles, connexion aux outils et aux données métier, contrôle des accès et des coûts. Vous voulez savoir si Mistral Large 4 convient à vos cas d’usage ? Nous pouvons lui faire passer ces épreuves, ou des épreuves construites sur vos propres documents.